Domain data-mining-software.de kaufen?
Wir ziehen mit dem Projekt
data-mining-software.de um.
Sind Sie am Kauf der Domain
data-mining-software.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain data-mining-software.de kaufen?
Was sind die verschiedenen Anwendungen von Data Mining in der heutigen Datenanalyse?
Data Mining wird verwendet, um Muster und Trends in großen Datensätzen zu identifizieren, um fundierte Entscheidungen zu treffen. Es wird in Bereichen wie Marketing, Finanzen, Gesundheitswesen und E-Commerce eingesetzt. Data Mining hilft Unternehmen, Kundenverhalten vorherzusagen, Betrug aufzudecken und Prozesse zu optimieren. **
Wie können Algorithmen zur Mustererkennung in der Datenanalyse und im maschinellen Lernen eingesetzt werden?
Algorithmen zur Mustererkennung können verwendet werden, um komplexe Datenmuster zu identifizieren und Vorhersagen zu treffen. Sie können in der Datenanalyse eingesetzt werden, um Trends, Anomalien und Zusammenhänge in den Daten zu erkennen. Im maschinellen Lernen können Algorithmen zur Mustererkennung verwendet werden, um Modelle zu trainieren, die automatisch Muster in den Daten erkennen und darauf basierend Entscheidungen treffen können. **
Ähnliche Suchbegriffe für Wahrscheinlichkeit
Top-Angebote
Produkte zum Begriff Wahrscheinlichkeit:
-
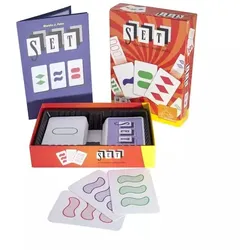
SET - das ungarische Gesellschaftsspiel zur MustererkennungEin wirklich cleveres Kartenspiel für die ganze Familie! SET ist das Spiel der Erkennung von Kombinationsmöglichkeiten, des schnellen Erfassens von Situationen und noch schnelleren Reaktionen. Ziel des Spiels ist es, SETs unter den aufgedeckten Karten zu finden. Jede Karte hat vier Merkmale: Farbe (rot, grün, lila), Form (oval, wellenförmig, Raute), Anzahl (eins, zwei, drei) und Füllung (voll, gestreift, leer). Ein SET besteht aus drei Karten, bei denen sich diese vier Merkmale entweder gleichen oder unterscheiden. Aber niemals dürfen zwei gleich sein und das dritte verschieden, denn das ist kein SET! Bist du bereit?14,79 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter

-
Was unterscheidet bedingte Wahrscheinlichkeit von unabhängiger Wahrscheinlichkeit?
Die bedingte Wahrscheinlichkeit bezieht sich auf die Wahrscheinlichkeit eines Ereignisses unter der Bedingung, dass ein anderes Ereignis bereits eingetreten ist. Sie wird berechnet, indem die Wahrscheinlichkeit des gemeinsamen Auftretens beider Ereignisse durch die Wahrscheinlichkeit des bereits eingetretenen Ereignisses geteilt wird. Im Gegensatz dazu ist die unabhängige Wahrscheinlichkeit die Wahrscheinlichkeit eines Ereignisses, unabhängig von anderen Ereignissen, die bereits eingetreten sind oder eintreten werden. **
-
Wie hoch ist die Wahrscheinlichkeit, beim Lotto zu gewinnen, gemäß der Statistik?
Die Wahrscheinlichkeit, beim Lotto zu gewinnen, hängt von der Anzahl der möglichen Kombinationen ab. Bei 6 aus 49 beträgt die Wahrscheinlichkeit, den Jackpot zu gewinnen, etwa 1 zu 139 Millionen. Die Wahrscheinlichkeit, zumindest einen kleinen Gewinn zu erzielen, ist jedoch höher und variiert je nach Anzahl der richtigen Zahlen. **
-
Was ist der genaue Unterschied zwischen Wahrscheinlichkeit und Likelihood in der Statistik?
In der Statistik bezieht sich die Wahrscheinlichkeit auf die Vorhersage zukünftiger Ereignisse basierend auf bekannten Informationen und Annahmen. Sie ist eine objektive Maßzahl, die auf mathematischen Berechnungen beruht. Der Likelihood hingegen beschreibt die Wahrscheinlichkeit, dass eine bestimmte Stichprobe aus den vorliegenden Daten gezogen wurde. Er ist subjektiv und basiert auf der Interpretation der Daten durch den Statistiker. **
-
Wie können wir mithilfe von Statistik die Wahrscheinlichkeit von zukünftigen Ereignissen berechnen?
Durch die Analyse von vergangenen Daten können wir Muster erkennen und Trends identifizieren, die uns helfen, die Wahrscheinlichkeit zukünftiger Ereignisse vorherzusagen. Mit Hilfe von mathematischen Modellen wie der Wahrscheinlichkeitstheorie können wir diese Daten quantifizieren und die Wahrscheinlichkeit von zukünftigen Ereignissen berechnen. Durch die Anwendung von statistischen Methoden wie Regression und Hypothesentests können wir auch die Unsicherheit unserer Vorhersagen abschätzen. **

Was sind die verschiedenen Ansätze für Clustering-Algorithmen und wie können sie zur Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Ansätze für Clustering-Algorithmen umfassen hierarchische, partitionierende und dichte-basierte Methoden. Diese Algorithmen können zur Gruppierung von Datenpunkten basierend auf Ähnlichkeiten oder Distanzen verwendet werden. Durch die Anwendung von Clustering-Algorithmen können Muster in den Daten identifiziert und für die Datenanalyse und Mustererkennung genutzt werden. **
Was sind die wichtigsten Vorteile von Clustering-Algorithmen in der Datenanalyse und wie können sie zur Mustererkennung verwendet werden?
Clustering-Algorithmen helfen, Daten in Gruppen zu organisieren, was dabei hilft, Muster und Strukturen in den Daten zu erkennen. Sie ermöglichen es, große Datenmengen effizient zu analysieren und Zusammenhänge zwischen den Datenpunkten zu identifizieren. Durch die Anwendung von Clustering-Algorithmen können Unternehmen beispielsweise Kundensegmente identifizieren und personalisierte Marketingstrategien entwickeln. **
Top-Angebote
Produkte zum Begriff Wahrscheinlichkeit:
-
Was sind die verschiedenen Anwendungen von Data Mining in der heutigen Datenanalyse?
Data Mining wird verwendet, um Muster und Trends in großen Datensätzen zu identifizieren, um fundierte Entscheidungen zu treffen. Es wird in Bereichen wie Marketing, Finanzen, Gesundheitswesen und E-Commerce eingesetzt. Data Mining hilft Unternehmen, Kundenverhalten vorherzusagen, Betrug aufzudecken und Prozesse zu optimieren. **
-
Wie können Algorithmen zur Mustererkennung in der Datenanalyse und im maschinellen Lernen eingesetzt werden?
Algorithmen zur Mustererkennung können verwendet werden, um komplexe Datenmuster zu identifizieren und Vorhersagen zu treffen. Sie können in der Datenanalyse eingesetzt werden, um Trends, Anomalien und Zusammenhänge in den Daten zu erkennen. Im maschinellen Lernen können Algorithmen zur Mustererkennung verwendet werden, um Modelle zu trainieren, die automatisch Muster in den Daten erkennen und darauf basierend Entscheidungen treffen können. **
-
Was unterscheidet bedingte Wahrscheinlichkeit von unabhängiger Wahrscheinlichkeit?
Die bedingte Wahrscheinlichkeit bezieht sich auf die Wahrscheinlichkeit eines Ereignisses unter der Bedingung, dass ein anderes Ereignis bereits eingetreten ist. Sie wird berechnet, indem die Wahrscheinlichkeit des gemeinsamen Auftretens beider Ereignisse durch die Wahrscheinlichkeit des bereits eingetretenen Ereignisses geteilt wird. Im Gegensatz dazu ist die unabhängige Wahrscheinlichkeit die Wahrscheinlichkeit eines Ereignisses, unabhängig von anderen Ereignissen, die bereits eingetreten sind oder eintreten werden. **
-
Wie hoch ist die Wahrscheinlichkeit, beim Lotto zu gewinnen, gemäß der Statistik?
Die Wahrscheinlichkeit, beim Lotto zu gewinnen, hängt von der Anzahl der möglichen Kombinationen ab. Bei 6 aus 49 beträgt die Wahrscheinlichkeit, den Jackpot zu gewinnen, etwa 1 zu 139 Millionen. Die Wahrscheinlichkeit, zumindest einen kleinen Gewinn zu erzielen, ist jedoch höher und variiert je nach Anzahl der richtigen Zahlen. **
Ähnliche Suchbegriffe für Wahrscheinlichkeit
-
SET - das ungarische Gesellschaftsspiel zur MustererkennungEin wirklich cleveres Kartenspiel für die ganze Familie! SET ist das Spiel der Erkennung von Kombinationsmöglichkeiten, des schnellen Erfassens von Situationen und noch schnelleren Reaktionen. Ziel des Spiels ist es, SETs unter den aufgedeckten Karten zu finden. Jede Karte hat vier Merkmale: Farbe (rot, grün, lila), Form (oval, wellenförmig, Raute), Anzahl (eins, zwei, drei) und Füllung (voll, gestreift, leer). Ein SET besteht aus drei Karten, bei denen sich diese vier Merkmale entweder gleichen oder unterscheiden. Aber niemals dürfen zwei gleich sein und das dritte verschieden, denn das ist kein SET! Bist du bereit?14,79 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Was ist der genaue Unterschied zwischen Wahrscheinlichkeit und Likelihood in der Statistik?
In der Statistik bezieht sich die Wahrscheinlichkeit auf die Vorhersage zukünftiger Ereignisse basierend auf bekannten Informationen und Annahmen. Sie ist eine objektive Maßzahl, die auf mathematischen Berechnungen beruht. Der Likelihood hingegen beschreibt die Wahrscheinlichkeit, dass eine bestimmte Stichprobe aus den vorliegenden Daten gezogen wurde. Er ist subjektiv und basiert auf der Interpretation der Daten durch den Statistiker. **
-
Wie können wir mithilfe von Statistik die Wahrscheinlichkeit von zukünftigen Ereignissen berechnen?
Durch die Analyse von vergangenen Daten können wir Muster erkennen und Trends identifizieren, die uns helfen, die Wahrscheinlichkeit zukünftiger Ereignisse vorherzusagen. Mit Hilfe von mathematischen Modellen wie der Wahrscheinlichkeitstheorie können wir diese Daten quantifizieren und die Wahrscheinlichkeit von zukünftigen Ereignissen berechnen. Durch die Anwendung von statistischen Methoden wie Regression und Hypothesentests können wir auch die Unsicherheit unserer Vorhersagen abschätzen. **
-
Was sind die verschiedenen Ansätze für Clustering-Algorithmen und wie können sie zur Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Ansätze für Clustering-Algorithmen umfassen hierarchische, partitionierende und dichte-basierte Methoden. Diese Algorithmen können zur Gruppierung von Datenpunkten basierend auf Ähnlichkeiten oder Distanzen verwendet werden. Durch die Anwendung von Clustering-Algorithmen können Muster in den Daten identifiziert und für die Datenanalyse und Mustererkennung genutzt werden. **
-
Was sind die wichtigsten Vorteile von Clustering-Algorithmen in der Datenanalyse und wie können sie zur Mustererkennung verwendet werden?
Clustering-Algorithmen helfen, Daten in Gruppen zu organisieren, was dabei hilft, Muster und Strukturen in den Daten zu erkennen. Sie ermöglichen es, große Datenmengen effizient zu analysieren und Zusammenhänge zwischen den Datenpunkten zu identifizieren. Durch die Anwendung von Clustering-Algorithmen können Unternehmen beispielsweise Kundensegmente identifizieren und personalisierte Marketingstrategien entwickeln. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.